
Insight
AI 에이전트가 늘어날수록, 왜 더 정교한 우선순위 정책이 필요해지는가

에이전트 하나가 만드는 연산량은 챗봇 한 번의 호출과 다르다
챗봇은 질의 한 건에 추론 한 번으로 끝나지만, 에이전트는 계획을 세우고 도구를 호출하고 다시 모델로 돌아오는 과정을 반복합니다.
Anthropic이 자사 멀티 에이전트 리서치 시스템의 운영 데이터를 공개한 자료(2025년 6월 기준)에 따르면, 에이전트는 일반 대화보다 토큰을 약 4배, 멀티 에이전트 시스템은 약 15배 사용하는 것으로 나타났습니다. 에이전트가 늘어나면 요청 수뿐 아니라 건당 소모되는 자원도 함께 커집니다. Anthropic은 멀티 에이전트가 성과를 내는 주된 이유로 문제 해결에 충분한 토큰을 투입하기 때문이라고 설명하며, 이 구조가 토큰 소모를 빠르게 늘린다는 점도 함께 밝혔습니다.
요청 규모의 편차가 커질수록 균등 할당 방식으로는 대응이 어렵다
같은 자료에서 Anthropic은 요청의 복잡도에 따라 투입되는 에이전트 규모가 달라진다고 설명합니다.
단순한 사실 확인은 에이전트 하나가 도구를 3~10회 호출하는 수준에서 끝나지만, 복합 조사에는 서브에이전트 10개 이상이 투입되기도 합니다. 두세 개 대상을 비교하는 질의는 서브에이전트 2~4개가 각각 10~15회를 호출하는 규모로 설명됩니다. 하나의 서비스 안에서도 요청별 자원 소요량이 크게 차이 날 수 있다는 뜻입니다. 모든 요청에 동일한 자원을 배정하는 방식에서는 가벼운 요청이 점유한 자원이 낭비되고, 무거운 요청은 부족한 자원이 부족하여 대기가 발생됩니다.
병목은 모델 성능보다 요청을 처리하는 순서에서 나타날 수 있다
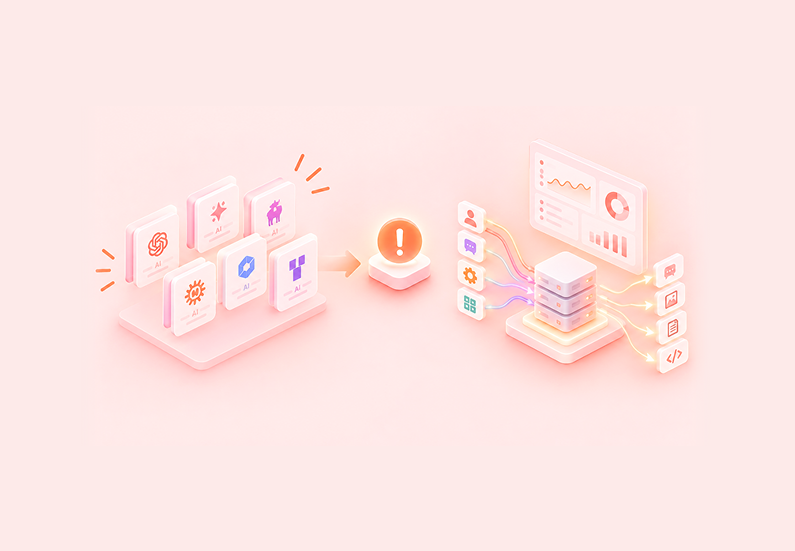
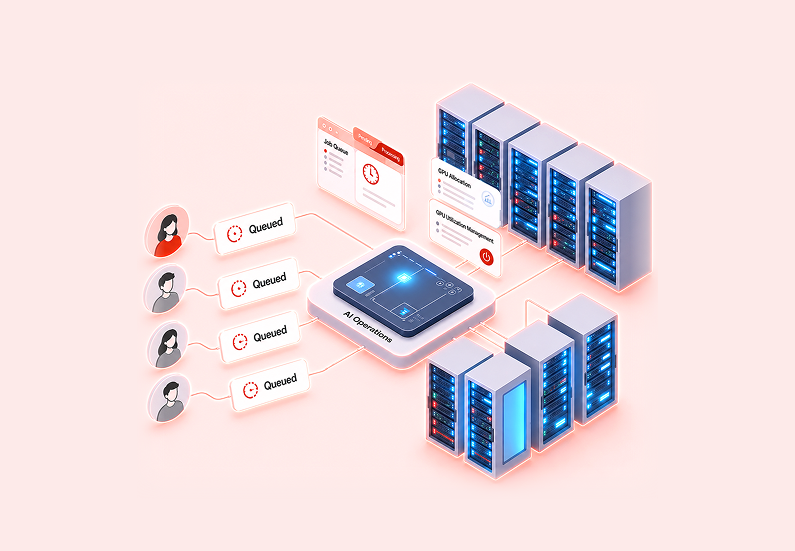
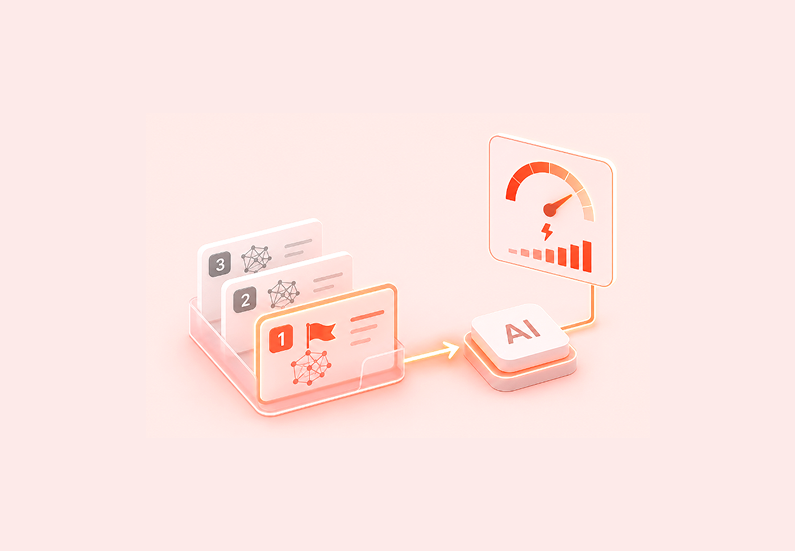
자원이 한정된 환경에서 병목은 모델 성능보다 요청 처리 우선순위에서 나타날 수 있습니다. 장시간 이어지는 에이전트 작업과 즉시 응답이 필요한 요청이 같은 대기열에 섞이면, 지연에 민감한 요청이 대규모 작업에 밀려 응답이 지연됩니다. 이를 줄이려면 요청 성격별 우선순위, 사용자와 프로젝트별 사용 한도, 우선순위가 높은 작업이 들어왔을 때의 자원 회수 기준이 필요합니다.
우선순위 정책은 자원을 나누는 단위와 함께 설계된다
우선순위 정책이 작동하려면 자원을 나누는 단위가 먼저 마련되어 있어야 합니다.
NVIDIA에 따르면 MIG(Multi-Instance GPU)는 GPU 하나를 최대 7개의 독립 인스턴스로 분할하며, 각 인스턴스는 전용 메모리와 캐시, 연산 코어를 갖습니다. NVIDIA는 낮에는 7개 인스턴스로 처리량이 낮은 추론을 수행하고, 밤에는 하나의 큰 인스턴스로 재구성해 학습에 쓰는 구성을 활용 사례로 제시합니다. 가벼운 에이전트 호출은 소규모 인스턴스에, 대규모 작업은 더 큰 자원 단위에 배분할 수 있습니다. 이처럼 자원을 나누는 기준이 명확해야 작업의 우선순위에 따라 어떤 자원을 누구에게 할당할지도 구체적으로 설정할 수 있습니다.
에이전트 확산 속도만큼 자원 사용량 관리가 핵심 과제가 된다
비용 통제도 같은 맥락에 놓여 있습니다. Gartner는 2025년 6월, 에이전틱 AI 프로젝트의 40% 이상이 비용 증가와 불분명한 사업 가치, 부족한 리스크 통제로 2027년 말까지 취소될 것으로 전망했습니다. 에이전트 확산과 함께 자원 사용량을 관리하는 체계가 중요해지고 있는 이유입니다.
클루닉스가 강조해 온 MIG/pGPU 기반 자원 배분, 프로젝트 기반 자동 스케줄링, 다중 사용자 환경 제어 기능은 이러한 정책을 담당자의 수작업이 아니라 운영 체계 안에서 일관되게 적용하기 위한 구성입니다.
에이전트 시대의 무게중심은 자원을 조정하는 운영 역량으로 이동하고 있다
에이전트가 늘어날수록 요청의 규모와 성격은 더 다양해지고, 병목은 모델보다 자원 배분 정책에서 나타날 수 있습니다. 요청 성격별 우선순위와 사용 한도, 이를 실행할 분할 단위가 함께 설계되면 한정된 자원을 요청 성격에 맞게 나눌 수 있습니다.
에이전트 도입을 확대하기에 앞서, 현재 운영 환경에서 자원을 조정하는 운영 역량이 마련되어 있는지 점검할 필요가 있습니다.