
Insight
AI 인프라 경쟁은 왜 ‘도입’보다 ‘운영 완성도’로 이동했는가

GPU를 ‘갖추는’ 능력은 이제 차별점이 되지 않는다
AI 인프라 논의는 대체로 더 많은 GPU, 더 큰 클러스터, 더 빠른 도입 속도를 중심으로 시작됩니다. 물론 이 요소들은 여전히 중요합니다. 다만 GPU가 보급되면서 ‘고성능 장비를 확보했다’는 사실 자체는 더 이상 기업 사이의 차별점이 되지 못하고 있습니다.
이에 따라 기업의 과제는 단순히 “얼마나 좋은 장비를 갖췄는가”에 머물지 않습니다. 갖춘 장비가 실제 환경에서 얼마나 안정적으로 가동되고, 필요한 시점에 적절한 워크로드에 누락 없이 할당되는지가 중요합니다. AI 인프라의 성능을 실제 업무 성과로 연결하기 위해서는 구축 규모와 운영 완성도를 함께 살펴볼 필요가 있는 이유입니다.
PoC 이후 실패는 모델의 문제가 아니라 운영의 문제다
AI 프로젝트가 가장 빈번하게 중단되는 지점은 모델 개발이 아니라 그 다음 단계입니다. S&P Global Market Intelligence가 북미·유럽 기업 1,000여 곳을 대상으로 조사한 결과에 따르면, AI 추진 과제 대부분을 중단했다고 답한 기업은 42%로 전년 17%에서 두 배 이상 늘었고, 기업들은 평균적으로 개념증명(PoC) 단계 프로젝트의 46%를 실제 운영 단계에 들어서기 전에 폐기했습니다. 시연 단계까지 완성하고도, 이것을 24시간 안정적으로 구동하는 단계에서 멈추는 조직이 적지 않다는 뜻입니다.
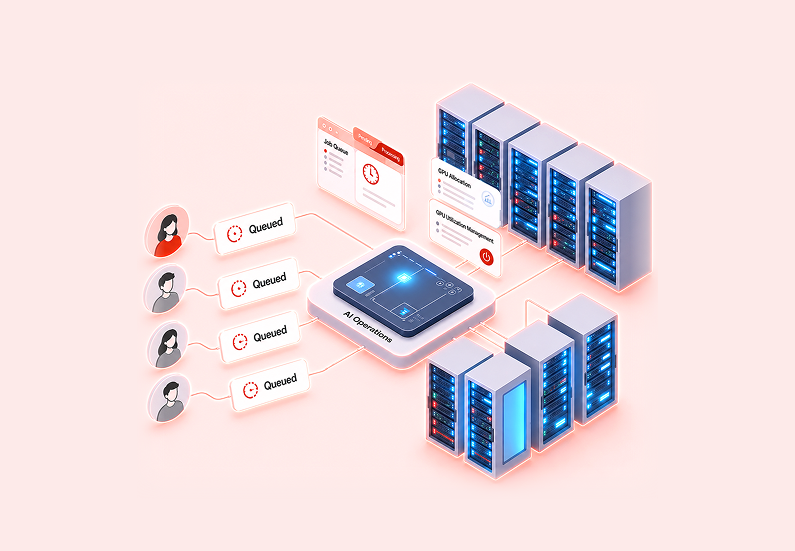
문제는 GPU의 절대적인 수량이 아닙니다. 미국 IT 기업 미란티스(Mirantis)의 분석에 따르면 상당수 조직이 고성능 GPU를 도입하고도 활용률 30% 미만에 머무는 것으로 나타났습니다. 막대한 비용을 들인 자원이 유휴 상태로 방치되는 동안 연구원들은 작업 대기열에서 순서를 기다리는, 이른바 ‘자원 풍요 속의 빈곤’이 반복되는 이유는 구축 규모가 아니라 운영 방식에 있습니다. 도입 경쟁의 무게중심이 운영 경쟁으로 이동하고 있는 이유입니다.
운영 단계에서는 속도, 비용, 우선순위, 가시성이 동시에 문제가 된다
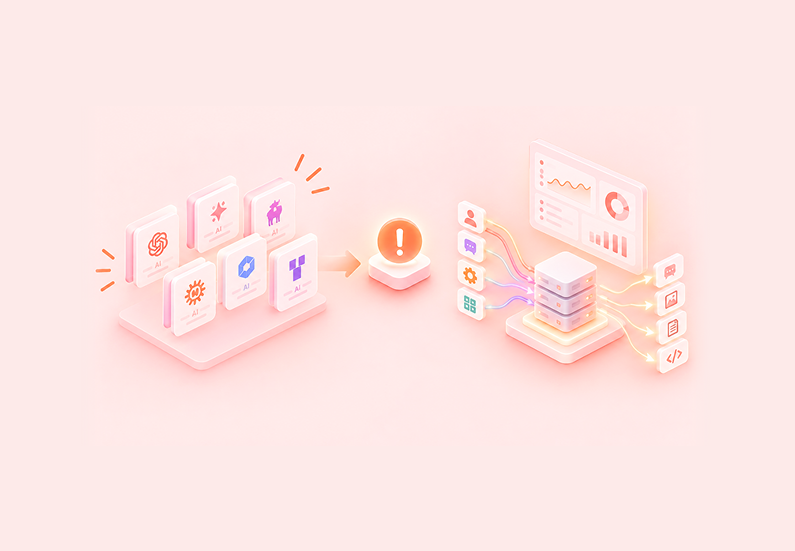
PoC 단계에서는 소수의 연구원이 소규모 데이터로 짧은 기간 실험하기 때문에 인프라 운영의 한계가 잘 드러나지 않습니다. 그러나 실제 운영 단계로 넘어가면 여러 팀이 동시에 자원을 요구하고, 학습 작업과 추론 서비스가 한 클러스터 안에서 뒤섞이면서 네 가지 문제가 한꺼번에 수면 위로 올라옵니다.
속도부터 살펴보면, 프로젝트마다 라이브러리 버전과 드라이버, 컨테이너 설정이 제각각이라 연구원은 개발을 시작하기도 전에 환경 설정에 매달리게 되고, GPU가 고정 점유 방식으로 배정되면 다른 연구원은 가용 자원이 생길 때까지 기다릴 수밖에 없습니다.
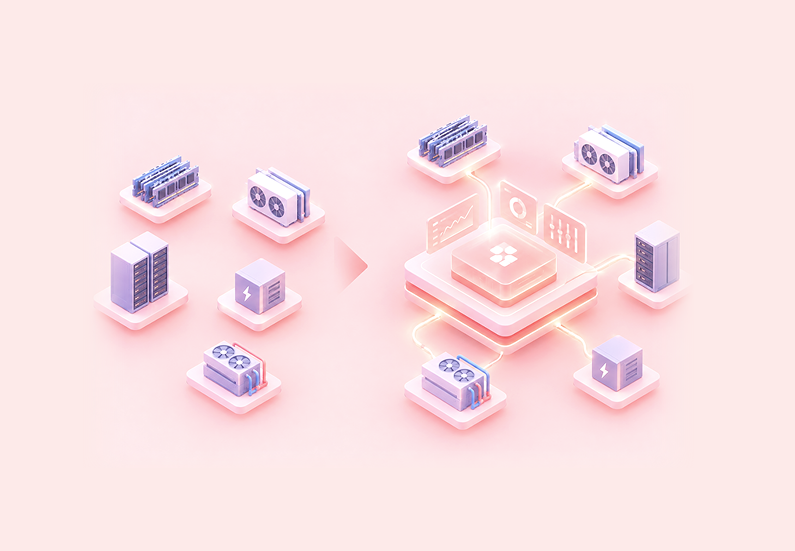
온프레미스와 클라우드를 따로 운영하다 보면 유휴 자원은 회수되지 않은 채 방치되고, 트래픽이 폭증하는 시점에는 클라우드 비용이 그대로 추가됩니다. 단순 선입선출 큐만 갖춘 환경에서는 회사의 핵심 프로젝트가 우선순위가 낮은 실험 뒤로 밀려 며칠씩 대기하는 일이 벌어집니다. 자원이 여러 클러스터와 클라우드에 파편화되면 전체 가동률이 실시간으로 보이지 않기 때문에, 특정 장비에 부하가 쏠리고 다른 장비는 놀고 있는 상황조차 확인하기 어렵습니다.
클루닉스는 이 네 가지 문제 중 ‘유휴 자원의 회수’를 가장 먼저 해결해야 할 과제로 봅니다. 누구도 쓰지 않는데 고정 점유로 묶여 있는 GPU를 실시간으로 감지해 대기 중인 작업에 재할당하는 것만으로도 새 장비를 들이지 않고 가용 자원의 총량을 늘릴 수 있기 때문입니다. 실제로 클루닉스가 고객사를 대상으로 진행한 자체 조사에 따르면, 정책 기반 자동 스케줄링을 도입한 기업들은 작업 대기 시간을 평균 36% 단축했습니다.
승부처는 구축 규모가 아니라 운영 완성도다
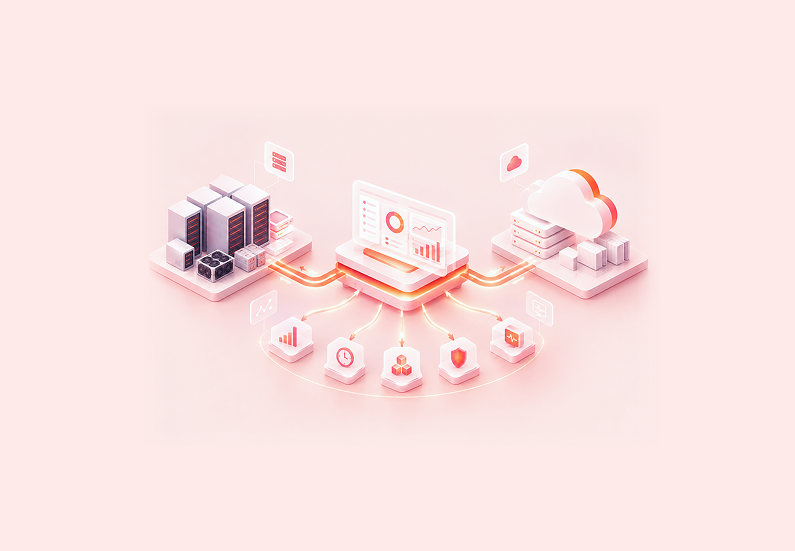
이 문제들의 해답은 장비를 더 추가하는 데 있지 않고 운영 체계를 다시 설계하는 데 있습니다. 하이브리드 운영, 통합 관제, 자동 스케줄링, 자원 가시성 확보는 개별 기능의 나열이 아니라, ‘운영 가능한(Operational) AI 인프라’라는 하나의 관점을 이루는 요소들입니다.
민감한 데이터가 있는 곳과 트래픽이 폭증하는 순간을 하나의 자원 풀 아래 연결하는 하이브리드 운영, 학습과 추론의 각 단계에 흩어진 도구를 하나의 화면으로 통합 관리하여 전체가 보이게 하는 통합 관제, 실패한 작업을 자동으로 재시작하고 프로젝트 중요도에 따라 자원 우선순위를 조정하는 자동 스케줄링, 그리고 실시간 가동률과 팀별 사용량을 측정해 증설과 운영 개선을 구분할 수 있게 하는 자원 가시성이 갖춰졌을 때, 비로소 GPU 투자가 실제 업무 성과로 이어집니다.
결국 중요한 것은 개별 자원을 효율적으로 관리하는 데 그치지 않고, 변화하는 워크로드와 인프라 조건에 맞춰 자원을 연결하고 조정할 수 있는 운영 환경을 갖추는 것입니다.